
Öne çıkanlar
- MiniMax M3.1 Flash ajan testlerinde liderliği ele geçirdi.
- Model token başına işlem maliyetini yirmide bire düşürüyor.
- Toplam 428 milyar parametreli model 23 milyar aktif parametre kullanıyor.
Yapay zekâ dünyasında donanım kısıtlamalarının sınırlarını zorlayan gelişmeler yaşanmaya devam ediyor. Çin merkezli yapay zekâ laboratuvarları, küresel çip tedarik zincirindeki zorluklara rağmen gelişmiş modeller çıkarmayı sürdürüyor. Bu alanda dikkat çeken çalışmalardan biri Çin'den yapay zekâ ihracatına lisans zorunluluğu taslağı getiren düzenlemeler ve Huawei'nin Floransa'daki yapay zekâ altyapı tanıtımları gibi sektör genelindeki dönüşümlerle aynı döneme denk geliyor. Bu kapsamda MiniMax laboratuvarı tarafından resmi olarak duyurulan MiniMax M3.1 Flash modeli, ajan tabanlı kıyaslama testlerinde en iyi maliyet ve performans dengesini sağlayarak liderliği ele geçirdi.
Sektörde Anthropic ve OpenAI gibi devlerin damıtma girişimlerine karşı önlem alması, Çinli laboratuvarların mevcut gidişatını koruyup koruyamayacağı konusunda soru işaretleri yaratıyor. Buna rağmen MiniMax (@MiniMax_AI), yeni modelin performans ekonomisini tamamen yeniden tanımladığını belirtiyor. Laboratuvarın paylaştığı bilgilere göre daha önce Space Bunny olarak bilinen model, küresel liderlik tablosunda zirveye yerleşen erken bir sürümün geliştirilmiş hali olarak öne çıkıyor. Öte yandan haftanın teknoloji gündemi içinde de yer alan bu tür donanım ve yazılım yenilikleri, yapay zekâ modellerinin verimlilik odaklı yeni bir döneme girdiğini gösteriyor.
Küresel Testlerde Lider Konum ve Teknik Yetenekler
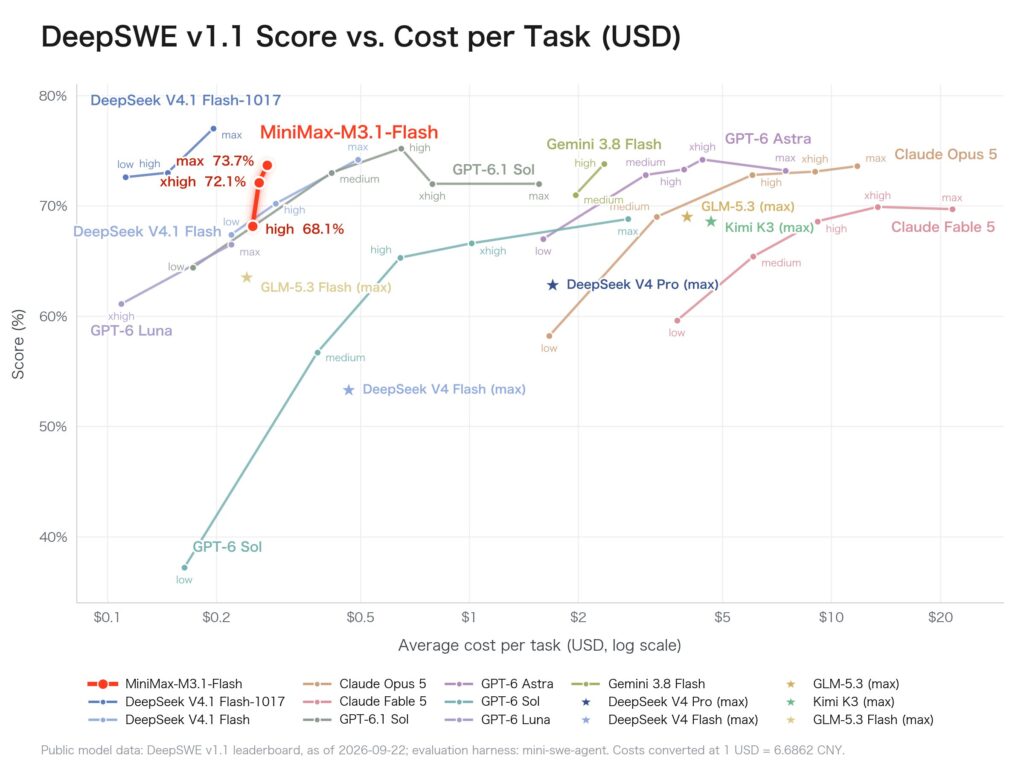
MiniMax M3.1 Flash, Automation Bench, Banker ToolBench ve LOCA-Bench-256K testlerinde küresel lider konumda bulunuyor. Benzer bir kategoride yer alan DeepSeek-V4.1-Flash-1017 modeli DeepSWE v1.1 testinde maliyete kıyasla birinci sırada kalmaya devam ederken, MiniMax M3.1 Flash hemen ardından ikinci sırada yer alıyor. Modelin daha güçlü kodlama, bilgisayar kullanımı, ajan ve siber güvenlik yetenekleri barındırdığı ifade ediliyor.
Çinli laboratuvarların toplam işlem kapasitesinin 100.000 adet H100 eşdeğeri grafik işlemcinin (GPU) altında kaldığı, MiniMax’in sahip olduğu mevcut işlem ayak izinin ise 70.000 seviyesinde bulunduğu biliniyor. Bu sınırlı donanım kapasitesine rağmen modelin üstün başarı göstermesi, arka planda gerçekleştirilen mimari optimizasyonlara dayanıyor. Yapay zekâ modellerinin dikkat katmanı kelimeler arasındaki bağlantıları incelerken, ileri besleme ağı derin matematiksel formüllerle kelimelerin anlamını ortaya çıkarıyor. MiniMax mühendisleri bu süreçleri optimize etmek için donanım kullanımını en üst düzeye çıkaran özel çözümler geliştirdi.
MiniMax M3.1 Flash teknik özellikleri
| Model Adı | MiniMax M3.1 Flash |
|---|---|
| Toplam Parametre | 428 milyar |
| Aktif Parametre | 23 milyar |
| Girdi Fiyatı | 0,15 dolar / 1 milyon token |
| Çıktı Fiyatı | 0,60 dolar / 1 milyon token |
| Çıktı Hızı | 200+ TPS (P50 170+) |
| Düşünme Seviyeleri | low, medium, high, xhigh, max |
Seyrek Dikkat Çerçevesi ve Önbellek Optimizasyonu
Modelin başarısının arkasındaki en önemli unsurlardan biri tescilli MiniMax Sparse Attention çerçevesi oluyor. Bu seyrek dikkat çerçevesi, bağlam penceresini token bazlı değerlendirmek yerine önbelleği bloklara sıkıştırıp maliyetsiz blok skoru hesaplıyor ve kritik blokların sadece yüzde 6 ila 7’lik kısmını tam işleme alıyor. Yapay zekâ modellerinde bağlam arttıkça büyüyen ve kelime ile cümle notlarının kaydedildiği önbellek anlamına gelen KV cache darboğazı bu sayede çözülüyor. Önbellek optimizasyonu, token başına işlem gereksinimini standart maliyetin yirmide birine düşürüyor.
MiniMax, sorgu ve dağıtık önbellek veri blokları arasındaki veri erişim düzenini optimize eden özel GPU çekirdekleri yazdı. Blok esaslı önbellek mimarisi, belleği dinamik sayfa bloklarına haritalandırarak bellek parçalanmasını tamamen ortadan kaldırıyor ve GPU kullanımını azami kapasitede tutuyor. Ayrıca matris çarpımı düzenleri, tensor çekirdeklerini durdurmadan indeks dallarını hızla takip edip puanlamak üzere özelleştirildi.
Çok Modlu İşleme ve Hız Artışları
MiniMax M3.1 Flash, metin tabanlı modele görsel adaptör eklemek yerine yerel görsel kodlayıcı kullanıyor ve iç içe geçmiş metin, görsel ve video verileriyle eğitildi. Görsel ve çok modlu işleme katmanı, görüntü ve video ön işlemeyi tamamen CPU kümelerine devreden Rust tabanlı sunucu geçitlerini kullanıyor. Küme genelinde 428 milyar toplam parametreli, farklı alt ağlara bölünerek sadece ilgili uzman ağların çalıştırıldığı mimari yaklaşım olan Mixture of Experts (MoE) modeli sunulması, bellek ve ağ darboğazlarına yol açabiliyor. Bu sorunu aşmak için Spekülatif Kod Çözme Hizalaması aşamasında küçük bir taslak model sonraki token’ları tahmin ederken, ayrı bir yol 23 milyar aktif parametre grubuyla paralel olarak doğrulama ve düzeltme yapıyor.
Yapılandırılan bu sistem sayesinde kullanıcı girdisini ilk okuma ve işleme aşaması olan Prefill aşamasında 9 kat, modelin işlenen girdiye dayanarak çıktı metnini üretme aşaması olan Decode aşamasında ise 15 kat hızlanma sağlanıyor. MiniMax tarafından paylaşılan verilere göre model, çevrimiçi çıkarımda yaklaşık 3 kat daha hızlı çalışıyor, ajan görevlerindeki maliyeti yüzde 70 düşürüyor ve günlük kullanımda P50 170+ olmak üzere 200+ TPS çıktı hızı sunuyor.
Kullanıcı Seçenekleri ve Desteklenen Arayüzler
Model, kullanıcılara esneklik sağlamak amacıyla düşük, orta, yüksek, xhigh ve varsayılan max olmak üzere beş farklı düşünme seviyesi sunuyor. Geliştiriciler ve son kullanıcılar modeli sistemlerine entegre edebilmek için HTTP, Anthropic SDK ve OpenAI SDK desteğinden yararlanabiliyor.
| Özellik | Değer |
|---|---|
| Model Adı | MiniMax M3.1 Flash |
| Toplam Parametre | 428 milyar |
| Aktif Parametre | 23 milyar |
| Girdi Fiyatı | 0,15 dolar / 1 milyon token |
| Çıktı Fiyatı | 0,60 dolar / 1 milyon token |
| Çıktı Hızı | 200+ TPS (P50 170+) |
| Düşünme Seviyeleri | low, medium, high, xhigh, max |