
Öne çıkanlar
- Açık kaynaklı yazılımlar RTX ekran kartlarının Tensor hızını iki kata çıkarıyor.
- Yöntem vBIOS veya sürücü değiştirmeden Linux çekirdek modülüyle çalışıyor.
- Uygulama oyun performansını etkilemezken yapay zekâ işlemlerini hızlandırıyor.
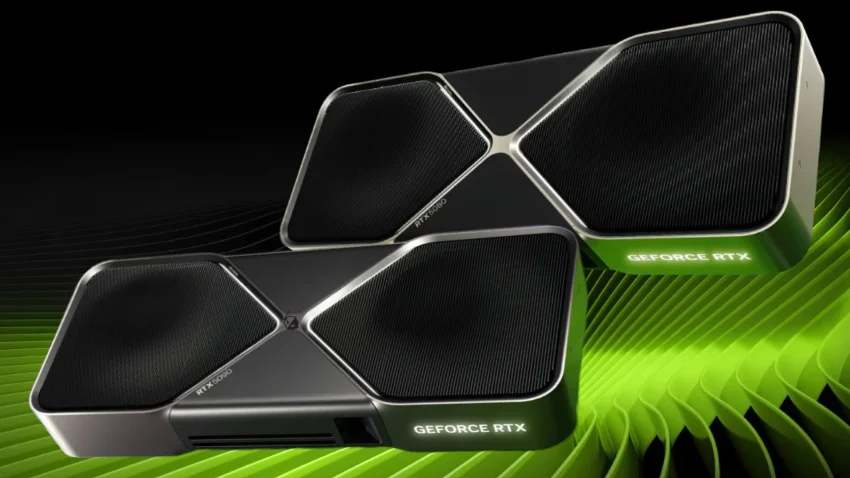
NVIDIA markasına ait GeForce RTX 30 ve 40 ailesi ekran kartlarındaki yapay zekâ hesaplama hız sınırlamalarını kaldıran açık kaynaklı yazılım yöntemleri, Tensor hesaplama işlemlerindeki hızı iki katına çıkarıyor. Bu gelişme, meraklıların ve geliştiricilerin ellerindeki donanımlardan daha fazla verim almasını sağlarken, topluluk odaklı optimizasyonların donanım dünyasındaki yerini bir kez daha gözler önüne seriyor.
GPU Unlock Yöntemi Nasıl Çalışıyor?
Geliştirilen açık kaynaklı GPU Unlock ve GPU Unlock Ada projeleri, donanım biriminin yapay zekâ matris işlemlerini yavaşlatan engelleri ortadan kaldırmayı başarıyor. Bu teknik uygulanırken ekran kartının vBIOS bellek yazılımına ya da ana sürücülere müdahale etmek gerekmiyor. Linux işletim sisteminde devreye giren özel bir çekirdek modülü, ana sürücü aktif hale gelmeden önce grafik birimi ayarlarını düzenliyor. Ardından sistem, PCIe Function Level Reset işlemi gerçekleştirerek sürücünün yüklenmesini sağlıyor.
Windows tarafında ise MSI marka RTX 4070 Ti ve Z490 anakart birleşimiyle yapılan UEFI testlerinde FP16 başarımının 84,08 TFLOPS seviyesinden 151,43 TFLOPS noktasına tırmandığı ve yüzde 80,1 oranında büyüme kaydettiği görüldü. Aynı denemede BF16 başarım hızı da 84,03 TFLOPS değerinden 148,25 TFLOPS ölçümüne ulaşarak yüzde 76,4 oranında artış gösterdi. Ancak bu süreç standart bir sürücü güncellemesinden farklı olarak çekirdek modülü kurulumu, önyükleme yapılandırması ve cihazın yeniden başlatılmasını zorunlu kılıyor. Güvenli açılış için Secure Boot ayarlarının da bu aşamada göz önünde bulundurulması önem taşıyor.
RTX Ekran Kartı Tensor Performans Değerleri teknik özellikleri
| RTX 4090 FP16 Tensor işlem hızı | 331,6 TFLOPS |
|---|---|
| RTX 4090 BF16 Tensor işlem hızı | 330,6 TFLOPS |
| RTX 4070 Ti SUPER güç sınırı | 240W |
| RTX 4070 Ti SUPER FP16 Tensor işlem hızı | 189,9 TFLOPS |
| RTX 4070 Ti SUPER BF16 Tensor işlem hızı | 189,7 TFLOPS |
| RTX 4070 Ti SUPER TF32 Tensor işlem hızı | 94,51 TFLOPS |
| RTX 4060 Ti 16 GB GPU | AD106 |
| RTX 4060 Ti 16 GB güç sınırı | 165W |
| RTX 4060 Ti 16 GB FP16 Tensor işlem hızı | 91 TFLOPS |
| RTX 4060 Ti 16 GB TF32 Tensor işlem hızı | 46,9 TFLOPS |
| RTX 4060 Ti 16 GB INT4 Tensor işlem hızı | 374,9 TOPS |
Model ve Seri Bazında Performans Artışları
Ampere mimarili RTX 30 serisi için hazırlanan ilk sistem altyapısı, Ada Lovelace mimarisini kullanan RTX 40 ailesine uyarlandı. RTX 4090 üzerinde uygulanan yöntem, TOTORONG imzasını taşıyan AD102 firmware çalışmalarının GPU Unlock altyapısına entegre edilmesiyle sonuç verdi. Bu sayede RTX 4090 modelinin FP16 işlem hızı 165,6 TFLOPS seviyesinden 331,6 TFLOPS değerine, BF16 işlem hızı ise 165,5 TFLOPS noktasından 330,6 TFLOPS seviyesine yükseldi. Yapılan bağımsız ölçümler, saniyede bir trilyon kayan noktalı işlem yapabilme kapasitesini belirten hesaplama hızı birimi olan TFLOPS cinsinden bu sıçramaları onayladı. Örnek vermek gerekirse, 24 Ekim tarihindeki bağımsız testlerde NVIDIA 615.78.08 sürücüsü ve 450W güç sınırı koşullarında FP16 hızı 160,4 değerinden 320,4 TFLOPS ölçümüne çıkarken, BF16 hızı da 159,7 noktasından 320,2 TFLOPS seviyesine ulaştı.
Teorik kapasitedeki bu büyük ivmelenme her zaman gerçek dünya uygulamalarına aynı oranda yansımıyor. Grafik işlemciler için hazırlanan temel doğrusal cebir alt programları kütüphanesi olan cuBLAS matris çarpımı testlerinde, FP16 başarımının matris büyüklüğüne göre yüzde 12 ila 34 aralığında arttığı saptandı. RTX 4070 Ti SUPER modelinde 240W güç sınırında FP16 ile BF16 hızları iki katına çıkarken, TF32 başarım hızı yüzde 99 oranındaki artışla 47,49 TFLOPS değerinden 94,51 TFLOPS seviyesine geldi. Aynı donanımda yüksek performanslı matris çarpımları ve lineer cebir rutinleri için kullanılan CUTLASS 4.8.1 hızlı biriktirme yöntemi tercih edildiğinde FP8 başarım hızı 158,54 TFLOPS değerinden 309,08 TFLOPS seviyesine tırmanarak yaklaşık 1,95 kat büyüme kaydetti. RTX 4060 Ti 16 GB sürümünde NVIDIA 595.99.02 sürücüsüyle testler gerçekleştirilirken, RTX 4080 SUPER için paylaşılan ölçüm sonuçları FP16 hesaplama hızının 110,6 TFLOPS değerinden 202,7 TFLOPS seviyesine çıktığını öne sürdü.
Önceki Nesil Kartlar ve Dikkat Edilmesi Gerekenler
RTX 30 ailesi için tasarlanan GPU Unlock projesi GA102, GA103, GA104 ve GA106 grafik yongalarında Tensor komut hızlarını yukarı taşıyor. RTX 3090 Ti ile gerçekleştirilen testlerde FP16 matris çarpımı başarımı 87,46 TFLOPS değerinden 118,39 TFLOPS seviyesine, BF16 başarım hızı 87,50 TFLOPS noktasından 157,41 TFLOPS değerine ve TF32 başarımı 42,58 TFLOPS seviyesinden 82,61 TFLOPS ölçümüne ulaştı. Bunun yanı sıra RTX 3090 modelinde BF16 matris çarpımları yüzde 25 ile 67 arasında, RTX 3080 10 GB modelinde yüzde 70 ile 73 oranında, RTX 3070 modelinde ise yüzde 73 ila 81 aralığında artış gösterdi. Büyük dil modellerinin test edilmesindeki prefill aşamasında yüzde 14 ile 36 arasında hızlanma kaydedilirken, token üretimi ile INT8 hesaplamalarında benzer bir hızlanma gözlemlenmedi. Saniyede bir trilyon işlem yapma kapasitesini belirten TOPS ölçü biriminin yanı sıra, bu yöntemin oyunlardaki kare hızını ya da standart FP32 ile INT8 hesaplamalarının başarımını yukarı çekmediğinin altı çiziliyor.
Sistemin kanıtlanan başarılarına rağmen resmi nitelik taşımayan bu açık kaynaklı yazılım uygulamalarının durumu henüz netlik kazanmış değil. Yöntemin bütün ekran kartı varyantlarında ve farklı bilgisayar bileşenlerinde aynı kararlılık düzeyinde çalışıp çalışmadığı bilinmiyor. Bağımsız test verileri hız artışlarını teyit etse de, uzun süreli kullanımlarda sistem kararlılığının nasıl şekilleneceği henüz test edilmiş değil.